原生AI桌面应用如何一周合入100个PR?Hermes v0.16.0工程拆解
2026/11/2 13:15:12
mall-customer的短期记忆原本是一个手写的 Redis 封装:把对话消息按会话 ID 存进 Redis list,读的时候取最近 N 条。封装本身是通的,但它和 Agent 图之间是断开的——消息存下来了,模型看不到。用户第一轮说"我要退款",第二轮说"给它升级优先级",客服会把第二句当成一件新的事处理:要么答非所问,要么再建一张新工单。
Agent State 本来就是用来记录整个图执行过程中的状态的,其中就包括消息——它完全可以替代原来那套短期记忆,只需要把这份状态持久化下来。框架已经提供了现成的做法——checkpointer:编译图时传入它,每个节点执行后的状态都会自动持久化,下一轮自动恢复,存进去的状态就是下一轮要用的。
所以这次改造没有重写短期记忆,只是把自建的 Redis 封装删掉,状态存取交给 checkpointer。过程中还清掉了状态模型里的两个冗余字段,并解决了暴露出来的两个问题。
memory/short_term.py短期记忆就围绕三个核心操作:
async def add_message(self, session_id: str, role: str, content: str) -> None: message = {"role": role, "content": content, "timestamp": datetime.now().isoformat()} key = f"smartcs:short_term:{session_id}" await r.rpush(key, json.dumps(message, ensure_ascii=False)) # 追加一条消息 await r.ltrim(key, -self.max_turns, -1) # 只保留最近 20 条 await r.expire(key, self.ttl_seconds) # 30 分钟过期Redis 里确实存放着最近的对话,/api/history也能读回来。但它和图是断开的,具体有两个问题:
/api/chat调用graph.ainvoke()时,初始 state 只带本轮这一条新消息:"messages": [HumanMessage(content=request.message)]。Redis 里存着 20 条历史,图里只读得到 1 条——历史从未注入状态,多轮追问缺少上下文。intent(路由给哪个 Agent)、compliance_passed(合规是否通过)这类编排状态。这些字段既不落 Redis、也不进下一轮,进程一重启就丢失。checkpointer 存到哪、怎么存:graph.compile(checkpointer=...)之后,每次执行都会以thread_id为键,把每个 superstep 之后的完整状态快照写入存储;下一轮用同一个thread_id调用ainvoke()时,框架先恢复上次的状态,再把这一轮的输入按 reducer(messages字段上是add_messages)合并进去;任何时刻都可以用graph.aget_state()读出当前状态。
Agent State 检查点读写流程:按 thread_id 读取 → 本轮执行 → 每个 superstep 写回 Redis
requirements.txt增加一行langgraph-checkpoint-redis>=0.5.0(本次接入用的 0.5.2);redis/redis-stack-server镜像,不用额外改;REDIS_URL环境变量补上密码。新的memory/short_term_memory.py里,初始化都放在setup()方法中:
# Agent State 检查点:TTL 30 分钟(读取/写入均刷新过期时间)CHECKPOINT_TTL = {"default_ttl": 30, "refresh_on_read": True}class ShortTermMemory: async def setup(self) -> None: """初始化 checkpointer:优先 Redis,失败降级进程内 MemorySaver""" from langgraph.checkpoint.memory import MemorySaver from langgraph.checkpoint.redis.aio import AsyncRedisSaver stack = AsyncExitStack() try: checkpointer = await stack.enter_async_context( AsyncRedisSaver.from_conn_string(self._redis_url, ttl=CHECKPOINT_TTL) ) await checkpointer.asetup() self._stack, self._checkpointer = stack, checkpointer except Exception as e: print(f"[ShortTermMemory] Redis checkpointer 初始化失败,降级为内存 MemorySaver: {e}") await stack.aclose() self._stack, self._checkpointer = None, MemorySaver()几个实现细节:
ttl控制的是会话的生命周期:default_ttl的单位是分钟,refresh_on_read: True表示读取时也续期——会话持续使用就一直存活,30 分钟没有读写才过期;from_conn_string()是异步上下文管理器,这里用AsyncExitStack手动进入,好处是进出成对:连接建立失败时,已申请的资源会被回滚掉,然后降级为进程内的MemorySaver,服务正常启动。降级只保证可用性——内存版重启即失效,多进程之间也不共享(当前版本里MemorySaver是InMemorySaver的兼容别名);asetup()负责建立 RediSearch 索引和 JSON 文档结构,启动时执行一次,幂等。在api/main.py的 lifespan 里,先初始化短期记忆,再把 checkpointer 传给图:
@asynccontextmanagerasync def lifespan(app: FastAPI): global graph # 短期记忆:Redis 持久化 Agent State,Redis 不可用时自动降级内存 await short_term_memory.setup() graph = create_supervisor_graph( working_memory=working_memory, long_term_memory=long_term_memory, checkpointer=short_term_memory.checkpointer, ) ... yield await short_term_memory.aclose()create_supervisor_graph的参数里,原来传的是short_term_memory对象,现在传checkpointer——图不再依赖具体的存储实现:
def create_supervisor_graph(..., checkpointer: Any | None = None, enable_checkpointing: bool = True): ... if checkpointer is None and enable_checkpointing: from langgraph.checkpoint.memory import MemorySaver checkpointer = MemorySaver() compiled = graph.compile(checkpointer=checkpointer) return compiled/api/chat里,会话 ID 直接当作thread_id。这一轮的初始 state 只包含新消息和业务字段,历史对话由框架恢复:
session_id = request.session_id or str(uuid.uuid4())config = {"configurable": {"thread_id": session_id}}initial_state = { "messages": [HumanMessage(content=request.message)], "user_id": request.user_id, "session_id": session_id, ...}result = await graph.ainvoke(initial_state, config=config)在/api/history里,通过读取图的状态快照获取对话历史:
async def get_history(self, graph: Any, session_id: str, last_n: int = 20) -> list[dict]: """读取会话对话历史 — 从 LangGraph Agent State(checkpointer)获取""" from langchain_core.messages import AIMessage, HumanMessage, SystemMessage try: snapshot = await graph.aget_state({"configurable": {"thread_id": session_id}}) except Exception: snapshot = None messages = (snapshot.values or {}).get("messages", []) if snapshot else [] role_map = {HumanMessage: "user", AIMessage: "assistant", SystemMessage: "system"} history = [ {"role": role_map.get(type(msg), "system"), "content": msg.text} for msg in messages ] return history[-last_n:]TTL 控制的是会话何时过期,不管状态里累积了多少消息——如果只有 TTL,持续时间长的会话,检查点里的消息会一直累积。旧实现用ltrim把列表裁到 20 条,新方案需要补上同样的条数限制。
做法是在图的入口加一个trim_history节点,紧跟本轮输入合并之后执行:消息数超过窗口的部分裁掉——用RemoveMessage把最旧的几条标记移除(而不是让 reducer 静默丢弃),经add_messages缩减之后再做路由。这样后续节点(Supervisor 路由、子 Agent、合规)读到的就是同一个窗口,checkpointer 落盘的也是有界状态:
# 短期记忆滑动窗口:Agent State 中最多保留最近 20 条消息(约 10 轮对话),# 超出部分由 trim_history 节点用 RemoveMessage 移除,防止状态无限增长MESSAGE_WINDOW_SIZE = 20def trim_history(state: AgentState) -> dict[str, Any]: """滑动窗口:把 Agent State 的消息裁剪到最近 MESSAGE_WINDOW_SIZE 条 作为图的入口节点执行,紧接着本轮的输入合并之后——保证后续所有节点的 LLM 只看得到窗口内的消息,checkpointer 持久化的也是有界状态。 通过 RemoveMessage 走 add_messages reducer 裁剪,而不是直接覆盖列表。 """ messages = state.get("messages", []) overflow = len(messages) - MESSAGE_WINDOW_SIZE if overflow <= 0: return {} removals = [RemoveMessage(id=m.id) for m in messages[:overflow] if m.id] return {"messages": removals}接线时把入口从supervisor_route改为trim_history:
graph.add_node("trim_history", trim_history) # 滑动窗口:裁剪超窗口的历史消息...graph.set_entry_point("trim_history")graph.add_edge("trim_history", "supervisor_route")和ltrim的差别在于:ltrim是物理删除,被裁掉的消息无法找回;RemoveMessage是往状态里提交一次"删除指令",由add_messagesreducer 处理,语义上仍是一次状态更新——和第四节合规撤回是同一套机制。窗口大小 20 条(约 10 轮对话),沿用旧实现的默认值。
接入 checkpointer 之前,AgentState里还有sub_results和final_response两个字段(节选):
class AgentState(TypedDict): messages: Annotated[list[BaseMessage], add_messages] user_id: str session_id: str intent: str sub_results: dict[str, Any] # 各子 Agent 的结果,按 Agent 名分桶 compliance_passed: bool final_response: str # 合成节点拼出来的最终回复 current_agent: str retry_count: intsub_results和final_response的问题在于:
sub_results["knowledge_rag"]这样的字典;这些内容不是消息,也不会被恢复成对话上下文;final_response是合成节点拼好之后再写回状态的,和 messages 里最后追加的那条 AIMessage 是同一份内容,存了两遍。既然会话状态都放在messages里,这两个字段就是多余的。改造后,子 Agent 的结果直接作为AIMessage写入messages——它既是要给用户的回复,也是下一轮对话历史的组成部分:
return { **state, "messages": [AIMessage(content=result)],}合成节点不再做拼接:末尾的AIMessage就是最终回复。
改造过程中处理了两个边界情况,均来自实际运行:
其一,合规不通过时,子 Agent 的结果要撤回。该结果已经写入messages;如果合规不通过只是追加一句转人工话术,违规内容会留在会话历史中,下一轮仍会作为上下文送入模型。因此需要用RemoveMessage将其移除:
if not state.get("compliance_passed", True): final_response = ( "抱歉,您的请求涉及敏感内容,已转交人工客服处理。" "工单编号已自动生成,请留意后续通知。" ) updates: list[BaseMessage] = [] if isinstance(last, AIMessage) and last.id: updates.append(RemoveMessage(id=last.id)) # 撤回子 Agent 的结果 updates.append(AIMessage(content=final_response)) return {**state, "messages": updates}RemoveMessage配合add_messagesreducer,按消息 id 移除已写入的消息——状态统一到 messages 之后,撤回才能这样实现。
其二,合规通过时,不再追加第二份"最终回复"。合成节点最初沿用旧逻辑:无条件把final_response追加进 messages,导致子 Agent 的回复与合成节点追加的回复同时存在,会话历史中出现两条内容相同的 AI 消息。修复方式是在追加前判断末尾是否为子 Agent 已写入的回复:
if isinstance(last, AIMessage) and bool(last.content): return state # 子 Agent 已写入回复,直接收尾配套地,合规节点的审查对象也从"sub_results拼接串"改成了"messages末尾的AIMessage";末尾没有子 Agent 的回复时(比如直达合规审查)直接跳过:
last = messages[-1] if messages else Noneif not isinstance(last, AIMessage) or not last.content: return {**state, "compliance_passed": True}compliance_result = await self.full_check(last.content)改造后的整张图:
业务咨询办理 / 投诉闲聊寒暄每个 superstep 读写用户消息trim_history裁剪到 20 条supervisor_route意图路由knowledge_ragticket_handlerchitchatcompliance_checksynthesize末尾 AIMessage即最终回复Redis Checkpointerid: session_id
状态改造完成、checkpointer 接入之后,多轮场景的测试显示上下文问题并没有完全解决。
测试会话中依次发送三条消息:
TK-20261011-B35059;TK-20261011-78F6D1;TK-20261011-80BF76。三条消息,三张工单。检查点里已存有完整历史,为什么升级优先级和查进度的请求仍在新建工单?
原因在ticket_handler的分析逻辑:分析请求时,只有最后一条消息进入了 LLM 的 prompt:
last_message = messages[-1].contentticket_info = await self.analyze_request(last_message) # 历史从未传入修复分两层:
# 关键修复:把对话历史一并交给分析 LLM,否则它只看得到最新一条消息,# 无法得知用户指代的已有工单(记忆存了却用不上)history_text = self._format_history(messages[:-1])ticket_info = await self.analyze_request(last_message, history_text)同时在系统 prompt 里把规则写死:指代、查询、处理已存在工单的消息(“那个工单”“它”“刚才的单子”“查一下进度”“给它升级优先级”),action必须是query或update,并从对话历史里提取工单号;此时严禁新建工单。
ticket_id,因此在历史消息中由新到旧扫描,用正则提取最近出现过的工单号作为兜底:TICKET_RE = re.compile(r"TK-\d{8}-[A-Fa-f0-9]{6}")def _extract_ticket_id(self, messages: list[Any]) -> str | None: """从对话历史(由新到旧)中提取最近出现的已有工单号。""" for m in reversed(messages): content = m.content if isinstance(m.content, str) else str(m.content) match = TICKET_RE.search(content) if match: return match.group(0) return None# 双保险:LLM 没带 ticket_id 时,直接从对话历史里提取ticket_id = ticket_info.get("ticket_id") or self._extract_ticket_id(messages)判定逻辑变成:
createupdate / queryupdatequery用户消息analyze_request携带最近 10 条历史action创建新工单ticket_id 取自 LLM缺失时正则兜底提取update_priority更新优先级query_ticket查询状态
改造验证过程中发现一类不必要的开销:用户只发送一句"你好",消息也会被路由到knowledge_rag,多出一次无意义的知识库检索。
解决办法是加一个chitchat节点,专门处理打招呼、感谢、告别这类非业务消息,不检索知识库,直接生成回复。行为约束写在系统 prompt 中:
CHITCHAT_SYSTEM_PROMPT = """你是一个友好的电商客服,负责处理用户的寒暄与闲聊。...回答规则:1. 简短友好,符合客服场景,不超过3句话2. 不检索、不编造任何业务信息(商品价格、订单状态等一律不回答)3. 不做任何业务承诺(退款、赔付、优惠等)4. 用户若提及具体业务问题,礼貌引导其重新描述,由知识库回答"""改动共三处:Supervisor 的路由 prompt 增加chitchat选项和路由规则(闲聊 → chitchat,不要为此检索知识库);图上注册chitchat节点,和另外两个子 Agent 一样汇聚到合规检查;route_map增加对应映射。
验证环境为本地 docker compose 启动的中间件(含redis-stack-server),mall-customer用python -m api.main直接启动,测试用例直接调用 Python 服务的接口,不经过 Java 后端,测的就是短期记忆本身。以下均为实际运行结果(模型回复每次生成略有不同)。
新建一个会话,依次发送两轮:
[轮1] user: 你好,我叫小明,记住我的名字[轮1] assistant: 你好小明,很高兴认识你!有什么需要帮忙的,比如查订单、退换货或商品咨询,都可以告诉我。[轮2] user: 我叫什么名字?[轮2] assistant: 你叫小明呀~我记住啦。有什么电商相关的问题需要我帮忙吗? ```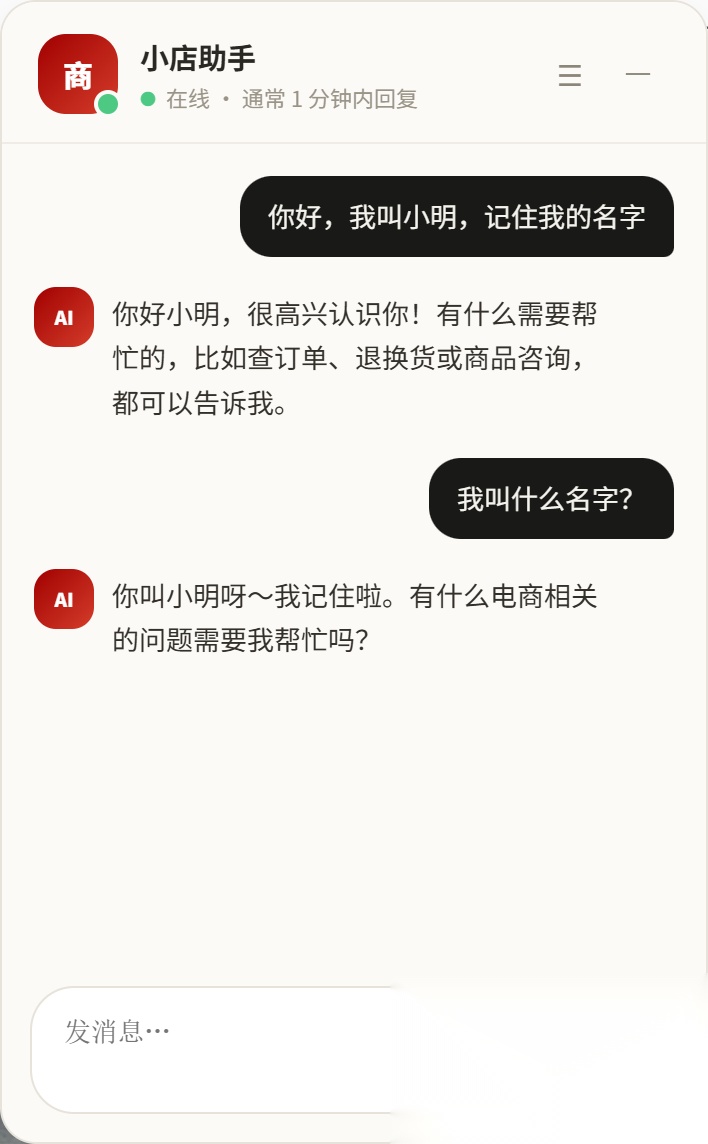 门户端智能客服两轮对话:第二轮正确回溯了第一轮告知的姓名 第二轮回答正确引用了第一轮的信息。随后读 `/api/history`,返回 4 条消息,角色顺序为 user / assistant / user / assistant,与对话一致;`last_n=2` 时只返回最近两条。 ### 跨进程重启的状态恢复 会话建立后,终止 `mall-customer` 进程并重启,再读 `/api/history`,4 条消息完整返回。重启后继续追问: ```plaintext user: 我刚才说我叫什么名字来着?assistant: 你刚才说你叫小明呀~我记着呢。有什么需要帮忙的吗? ```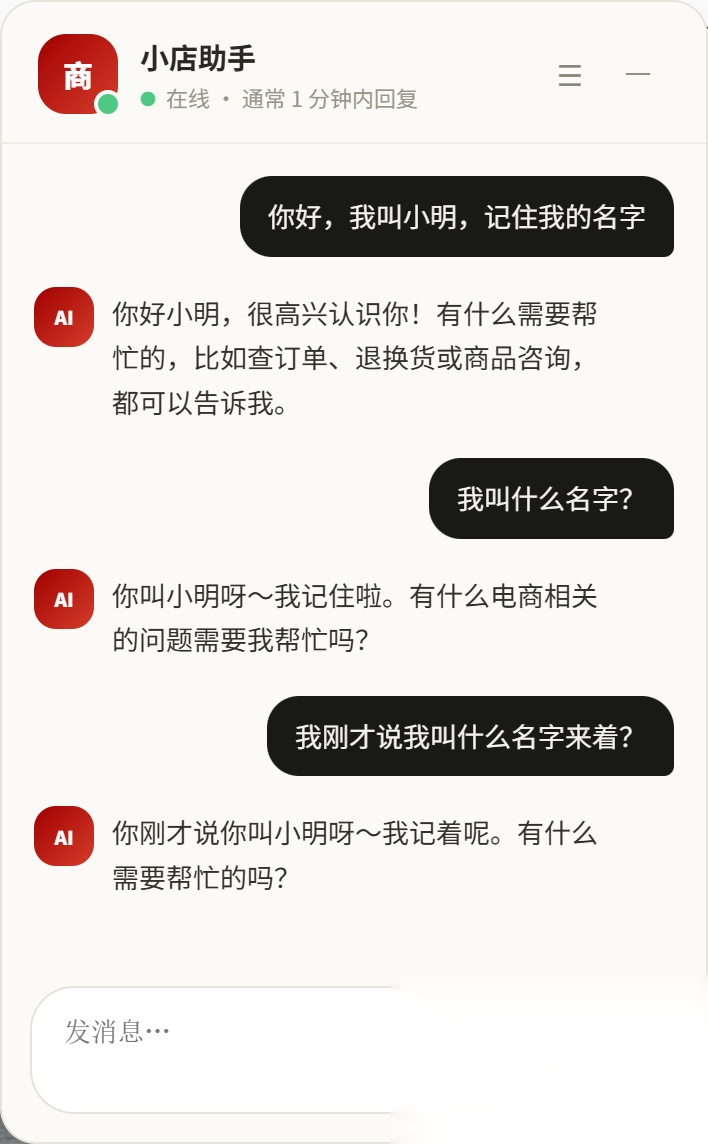 重启 mall-customer 进程后完整历史恢复,新回复正确引用重启前告知的姓名 ### 多轮工单:修复前后 同一个场景(建单 → 要求升级优先级 → 查进度)在修复前后分别验证: * • 修复前:三条消息建了三张工单(`TK-20261011-B35059` / `TK-20261011-78F6D1` / `TK-20261011-80BF76`),升级优先级和查进度均被当作新诉求; * • 修复后:第一条消息建单 `TK-20261011-6C4751`(中等优先级);第二条"太慢了,给它升级为紧急优先级"返回"工单已更新成功!工单号: TK-20261011-6C4751 ⚡ 优先级: 紧急";第三条"查一下它的进度"直接查回同一张单,更新时间正是升级优先级操作的时间。全程只存在一张工单。 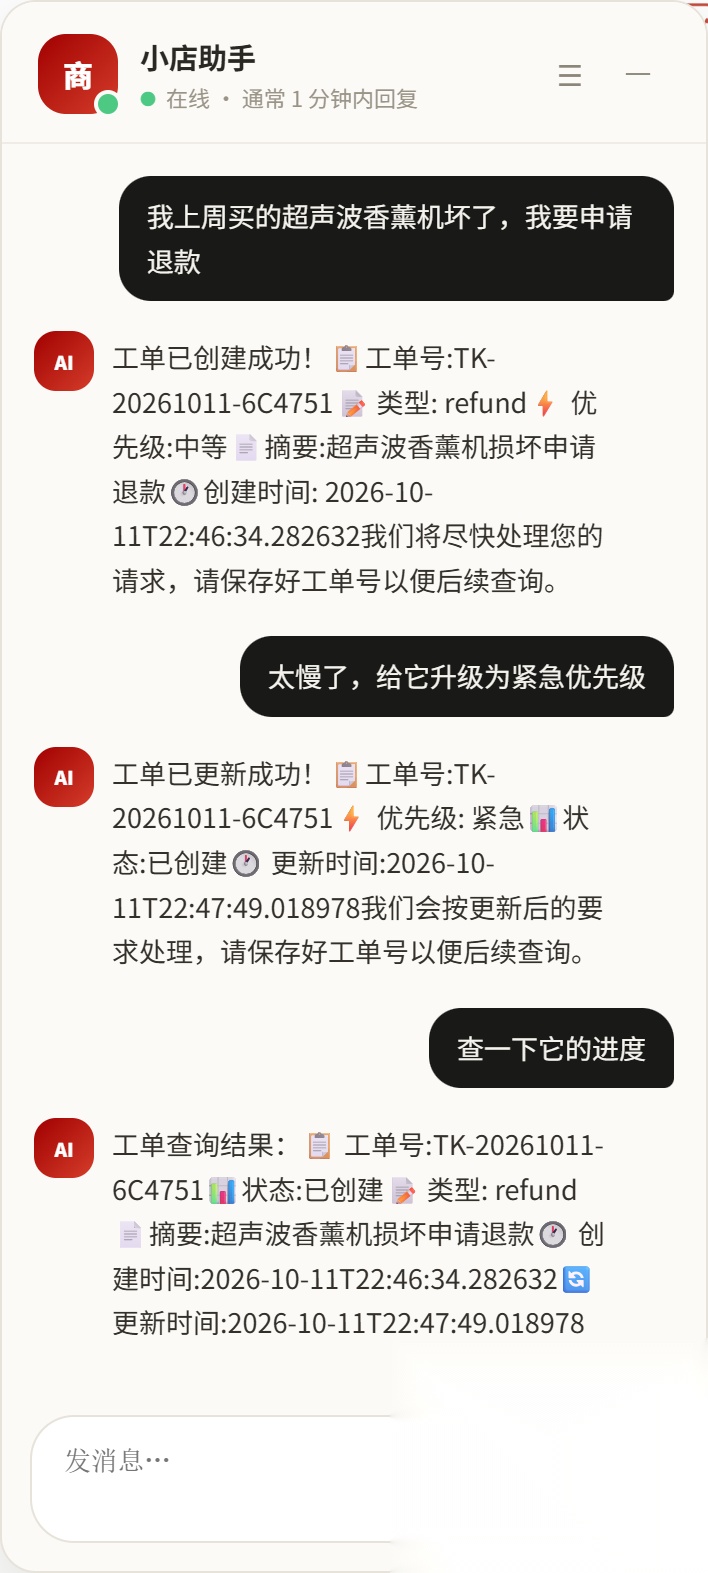 修复后同一条工单贯穿建单、升级优先级与进度查询 ### 合规撤回与消息去重 这两条路径涉及不适合展示给用户的内容,无法通过对话直接验证,因此用 `FakeListChatModel` 编写临时冒烟脚本,按图的三条出口分别断言: * • 合规通过:历史里只有一条 AI 回复,没有重复追加; * • 合规不通过:子 Agent 的违规结果被 `RemoveMessage` 撤回,`messages` 里查不到,只留转人工话术; * • 直达合规:追加兜底话术"抱歉,暂时无法处理您的请求,请稍后重试。"; * • 三轮累积对话:第 1 轮的回复仍在、第 2 轮违规内容没有泄漏、第 3 轮的兜底话术正常,`messages` 长度与轮次严格对应。 以上断言全部通过。 ### Redis 里存了什么 一个会话在 Redis 里的实际键(会话 ID `test-stm-3ffa40b6`): ```plaintext checkpoint:test-stm-3ffa40b6:__empty__:{checkpoint_id}checkpoint_latest:test-stm-3ffa40b6:__empty__checkpoint_write:test-stm-3ffa40b6:__empty__:{checkpoint_id}:{task_id}:{序号}write_keys_zset:test-stm-3ffa40b6:__empty__:{checkpoint_id}checkpoint:是每个 superstep 的状态快照;checkpoint_write:是各节点执行的写入记录(channel 更新);checkpoint_latest:指向该会话最新的检查点;write_keys_zset:记录某次检查点关联的写入键,交给 saver 统一管理 TTL;__empty__是空命名空间(checkpoint_ns)在存储层的占位,子图场景才会取别的值;default_ttl: 30分钟,且会随读写刷新。窗口部分,验证会话连续进行了 15 轮对话,状态中的消息数在第 10 轮达到 20 后不再增长:每轮入口先裁到 20 条再处理本轮,轮末最多到 21(20 条窗口 + 本轮回复),下一轮入口再次裁剪;到第 15 轮时,最早的几轮对话已滑出窗口。向一个会话直接写入 22 条消息再触发一轮,最早 2 条被RemoveMessage移除,从第 3 条开始保留。
降级路径同样验证过:把REDIS_URL指向一个不存在的端口启动,服务打印降级日志后正常启动,checkpointer 类型从AsyncRedisSaver变为InMemorySaver:
[ShortTermMemory] Redis checkpointer 初始化失败,降级为内存 MemorySaver: ...Redis 不可用时 => InMemorySaverRedis 可用时 => AsyncRedisSaver这次改造去掉了手写的状态存取,交给框架来做:
AsyncRedisSaver以thread_id为键持久化整份会话状态:TTL 30 分钟失效,trim_history节点把状态裁剪到最近 20 条,Redis 不可用时自动降级进程内存储;AgentState里只留messages一条主线:子 Agent 的结果直接作为消息存入短期记忆,合规撤回用RemoveMessage,合成节点不再重复追加;🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
保证100%免费】